Claude Code の並列作業を worktree で分ける|作成からマージ・片付けまで
Claude Code を並列で走らせるときは、セッションごとに Git worktree で作業ディレクトリとブランチを分けます。worktree の中にセッションを立て、差分を確認して main へ1本ずつマージし、済んだツリーを片付ける。この一巡を1作業ずつ最後まで通せば、同時に編集していても互いの変更が上書きされることはありません。
Claude Code の並列作業は、なぜ同じ作業ディレクトリだとぶつかるのですか
作業ディレクトリが共通のままだと、2つのセッションが同じファイルを同時に開くことになるからです。片方が保存した瞬間、もう片方が抱えている編集中の内容はその上に重なります。worktree でセッションごとにディレクトリを分ければ、同じファイルへの同時編集で上書きは起きません。
分けたあとは、各セッションが自分の環境にある最新の状態だけを見て進められます。とはいえ、マージのときにコンフリクトが出なくなるわけではありません。同じ関数や同じ設定値に両方が手を入れていれば、1本ずつ統合する段階でぶつかります。worktree が防げるのは同時編集中の上書きだけで、統合時の衝突はレビューとマージの側で扱います。
worktree 以外にも、ターミナルの分割、tmux、VSCode のウィンドウ追加といったやり方があります。複数のプロセスを同時に走らせられる点は同じですが、参照先は同じリポジトリの同じルートであることが多く、ファイル競合のリスクは残ります。ターミナル分割で走らせていて編集がときどきぶつかるなら、原因はここです。ディレクトリごと独立させれば、同じファイルに同時に手が入る状態は作らずに済みます。
リポジトリと worktree はどうつながっていますか
親になるリポジトリは1つです。そこから並列セッションの数だけ worktree を分け、各セッションは与えられた作業ディレクトリの中で作業します。親側の main はそのまま残り、横に増えた作業ツリーがそれぞれ自分のブランチを持ちます。
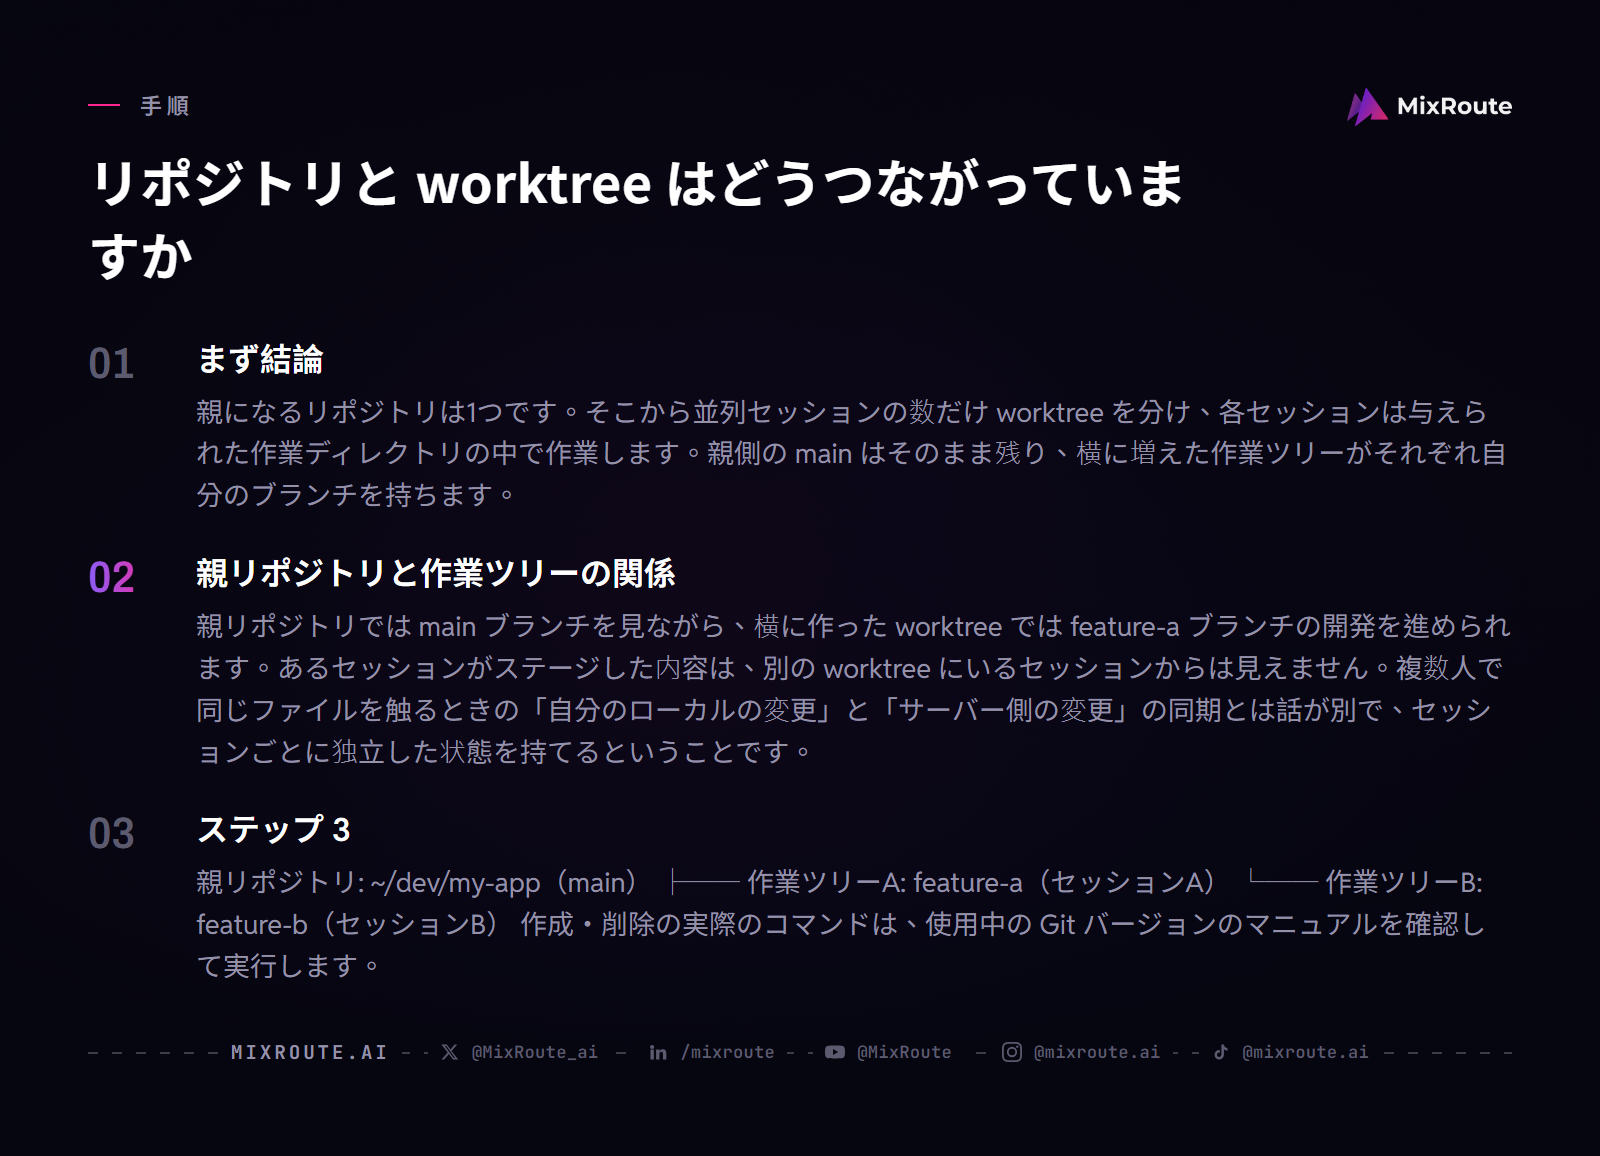
親リポジトリと作業ツリーの関係
親リポジトリ: ~/dev/my-app(main)
├── 作業ツリーA: feature-a(セッションA)
└── 作業ツリーB: feature-b(セッションB)

作成・削除の実際のコマンドは、使用中の Git バージョンのマニュアルを確認して実行します。
親リポジトリでは main ブランチを見ながら、横に作った worktree では feature-a ブランチの開発を進められます。あるセッションがステージした内容は、別の worktree にいるセッションからは見えません。複数人で同じファイルを触るときの「自分のローカルの変更」と「サーバー側の変更」の同期とは話が別で、セッションごとに独立した状態を持てるということです。
置き場所は、手動で作るなら親リポジトリフォルダの隣(../my-app-feature-a のように)が扱いやすいです。Claude Code の claude --worktree 名前 を使う場合は、既定でリポジトリ内の .claude/worktrees/名前/ に作られます。親側で未追跡ファイルとして見えないよう、.gitignore に .claude/worktrees/ を追加しておきます。
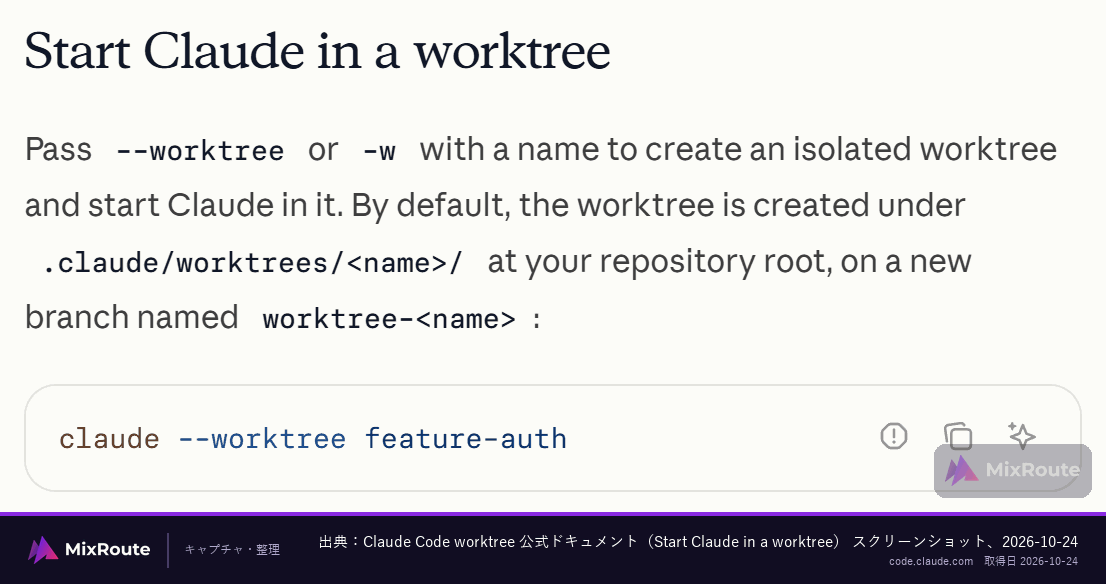 / を示す公式ドキュメントの節”/>
レビューでは、差分の一覧、テスト結果、変更した worktree とブランチをセットで残します。マージの前に基準ブランチを更新し、相手の変更を取り込む必要があるかを確かめます。統合したら同じテストをもう一度流し、問題が出たときにマージ前のブランチへ戻せる状態にしておきます。作業ツリーを消すのは、その確認が終わってからです。
worktree で作成・レビュー・マージ・片付けはどう進めますか
worktree を切る、セッションを起動する、差分をレビューする、main にマージする、マージ済みを片付ける。1つの作業はこの順番で最後まで通します。各段階で見るポイントは次のとおりです。
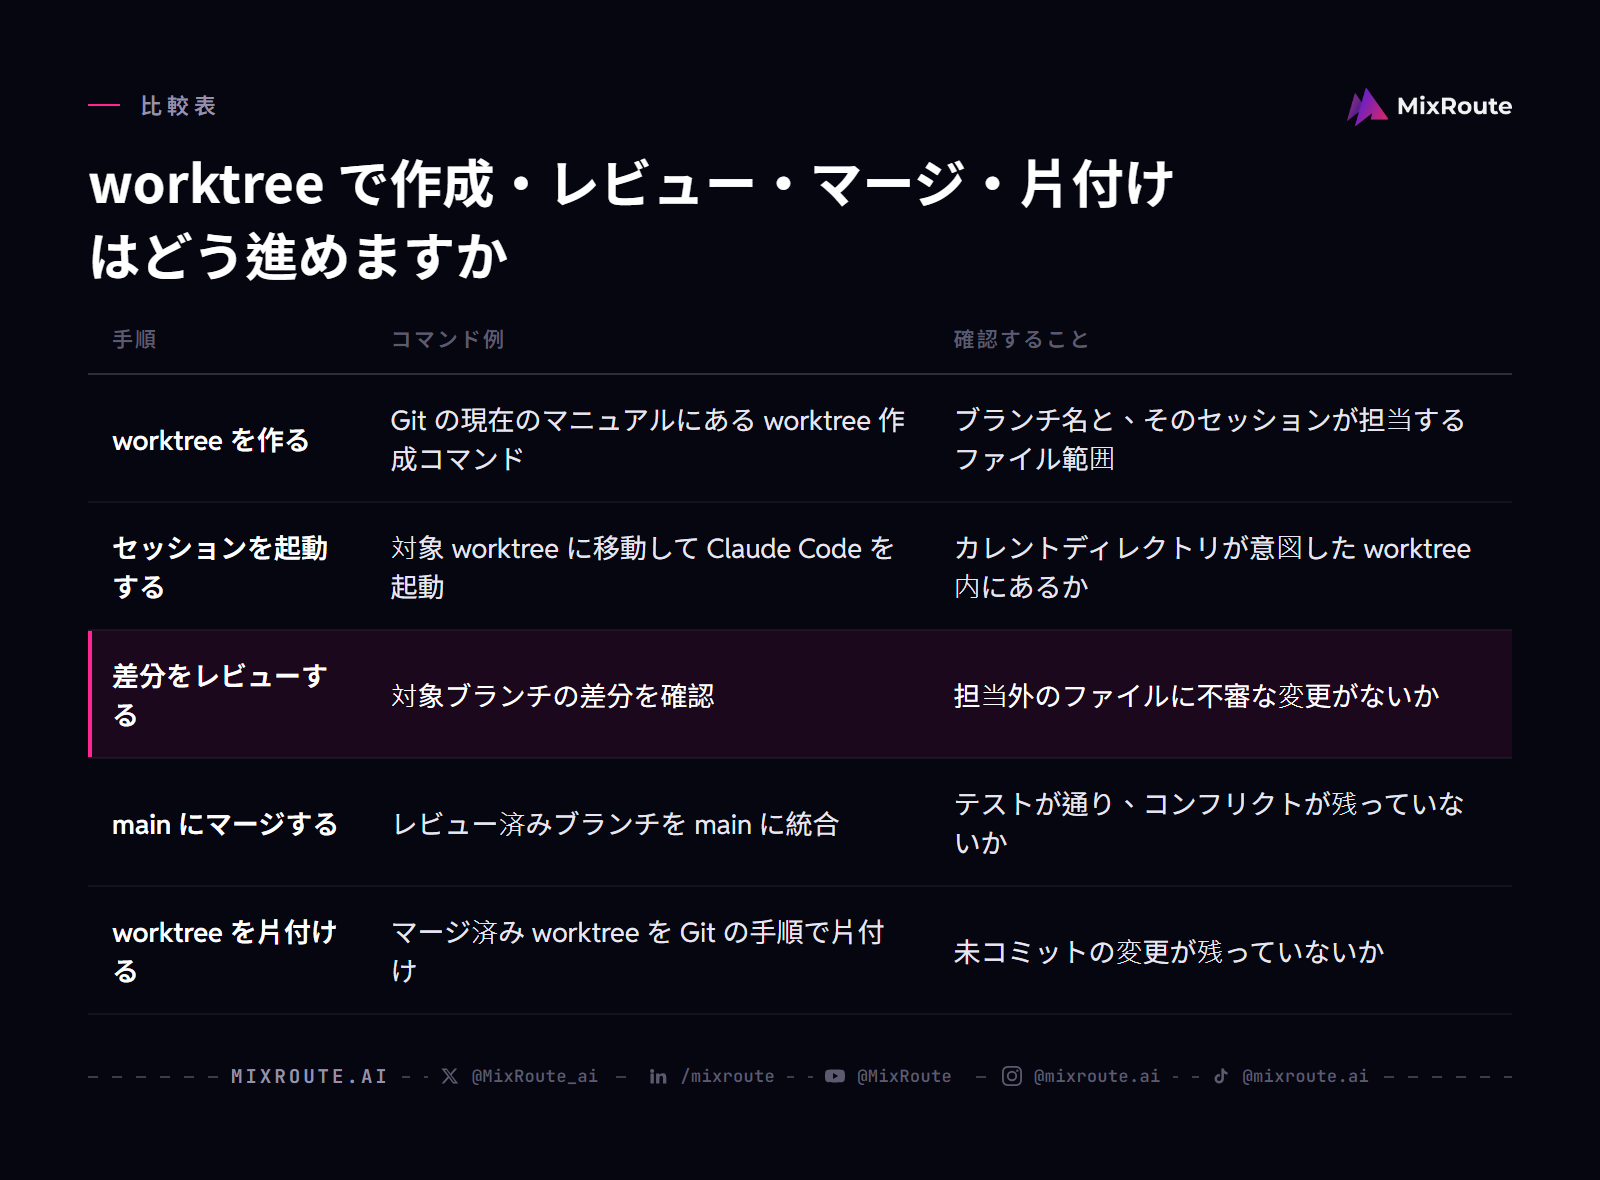
作成から片付けまでの手順
| 手順 | コマンド例 | 確認すること |
|---|---|---|
| worktree を作る | Git の現在のマニュアルにある worktree 作成コマンド | ブランチ名と、そのセッションが担当するファイル範囲 |
| セッションを起動する | 対象 worktree に移動して Claude Code を起動 | カレントディレクトリが意図した worktree 内にあるか |
| 差分をレビューする | 対象ブランチの差分を確認 | 担当外のファイルに不審な変更がないか |
| main にマージする | レビュー済みブランチを main に統合 | テストが通り、コンフリクトが残っていないか |
| worktree を片付ける | マージ済み worktree を Git の手順で片付け | 未コミットの変更が残っていないか |
マージは1本ずつです。2本以上を同時に統合すると、そのコンフリクトがどちらの作業ツリーから来たものか分かりにくくなります。並列に慣れていないうちは、1つのセッションを完了させてから次を足すほうが流れをつかみやすいです。AI と一緒にコードを書く往復そのものを先に身につけたいなら、関連する開発の進め方を見るという順番もあります。
担当ファイル、ブランチ名、レビュー担当、完了条件を先に決めておくと、セッションがどこまで進んでよいかがはっきりします。起動したらすぐカレントディレクトリとブランチを表示させ、意図した作業ツリーにいるかを確かめます。担当外のファイルに手を入れる必要が出たら、その場で範囲を広げず、いったん止めて統合担当に共有します。これだけで、同じファイルを別のセッションが触る事故と、レビュー対象が膨らむ手戻りに早く気づけます。
衝突を避けるために、走らせる前に何を決めておきますか
決めるのは2つ、セッションごとの担当ファイルと、何をもって完了とするかです。ここが曖昧なまま走らせると、同じファイルを2つのセッションが触って上書きしたり、終わったのか分からない差分がレビュー待ちに積み上がったりします。
先に決める2つ
1つ目は、どのセッションがどのファイルに触るかです。同じファイルに手を入れる必要が出たら、並列にはせず順番に回します。設定ファイル、ルーティング、スキーマ定義、依存関係の一覧は、同時に触るとコンフリクトが起きやすいところです。これらの更新を1つのセッションに寄せておけば、後から差分をほどくより安く済みます。
2つ目は完了の条件です。テストが通る、型エラーが残っていない、レビューで見る差分の範囲はここまで、と決めておきます。これが曖昧なままだと、セッションは「たぶん終わった」状態で待機してしまい、レビュー担当者は何を確かめればよいか分からなくなります。ゴールラインを引いておけば、セッションもそこに向かって集中して処理を進められます。
未コミットの変更が残った worktree はどう扱いますか
消す前に、未コミットの変更が残っていないかを確かめます。残っていればコミットするか退避させてから削除します。捨てるつもりのない変更を消してしまう事故は、この一手で止められます。
消すのはマージが済んだものからです。未完成の worktree を急いで消すと、作業の流れが途中で切れて、引き継げたはずの文脈が欠けます。マージ済みを片付けてから、次を走らせる準備を整えます。
接続設定は、リポジトリごとの秘密情報とは分けて管理します。API キーはコードにもコミットにも置かず、各セッションが同じ環境変数を参照できる状態だけを用意します。最初は1つの worktree から最小のリクエストを送り、応答を確認してから残りのセッションを起動します。失敗したときは worktree の分離の問題なのか接続設定の問題なのかを切り分けることになるので、モデル名、base URL、実行ログの時刻が手元にあると判断が早くなります。
並列セッションの呼び出し先はどうそろえますか
呼び出し先は全セッションで同じままでかまいません。Claude Code は ANTHROPIC_BASE_URL に指定した先へ Anthropic Messages 形式でリクエストを送ります。MixRoute なら Anthropic 互換の base URL、https://api.mixroute.ai(/v1 は付けません)を全セッション共通で指定します。worktree は作業ディレクトリを分ける仕組みで、API の接続先を分ける仕組みではないからです。
接続先は1つにそろえる
MixRoute の OpenAI 互換エンドポイントを使うなら、base URL とモデル名は設定項目として管理できます。モデルを切り替えられるか、料金がいくらかは、現在のモデル一覧と利用中の SDK の説明に書かれています。
接続先が1つに決まっていれば、worktree ごとに設定を書き分ける必要はありません。
本番のトラフィックも同じ経路に寄せる場合は、自社の構成に合わせた接続先の設計を相談すると話が早いです。
どんな作業が並列に向き、同時にいくつ走らせますか
独立した小さな機能追加をいくつも抱えているなら、並列にする効果が出やすい場面です。効くのはファイルを共有しない作業で、同時数は一律には決められません。タスクの独立度と、手元のマシンの資源で変わります。
向く作業と向かない作業
| 向く作業 | 向かない作業 |
|---|---|
| 独立したファイルを触る機能追加 | 同じファイルを触る修正の並行作業 |
| 失敗してもやり直せる調査や試作 | 順番が決まっているスキーマ変更やマイグレーション |
| テストやドキュメントの追加 | 共通の設定ファイルやライブラリの同時変更 |
同時数はどう決めるか
現実的なのは、まず2つで試し、レビューとマージが回るようになってから足すやり方です。3つのセッションがそれぞれビルドとテストを走らせるだけで、マシンが一時的に重くなることがあります。増やすかどうかは、マシンの余裕と、レビュー待ちの差分がたまっていないかの両方で判断します。
手元のマシンより先に、API 側のレートリミットに当たることもあります。セッションを増やす前に現在の契約とサービス側の制限を確認しておき、429 が出たら同時数を戻して原因を切り分けます。
FAQ
worktree を使わずに Claude Code を並列で動かす方法はありますか?
あります。ターミナルを分ける、tmux を使う、VSCode のウィンドウを増やす、のいずれかです。プロセスを複数同時に動かせる点は worktree と同じですが、見に行く先は同じリポジトリの同じルートなので、同じファイルに手が入れば衝突します。ファイル競合そのものを避けたいなら作業ディレクトリを分け、画面だけ分けて見たいならターミナル分割で足ります。
worktree を分けると、何が衝突しなくなりますか?
同時編集の衝突です。各セッションが自分の作業ディレクトリを持つので、片方が保存した内容がもう片方の手元に重なることはありません。ブランチも別になるため、どのコミットがどのセッションの作業なのかを取り違えにくくなります。ただしマージの段階でコンフリクトがなくなるわけではなく、同じ関数や設定値に両方が手を入れていれば統合するときにぶつかります。
ファイル競合はどう防ぎますか?
走らせる前に、どのファイルをどのセッションが触るかを決めておきます。担当を分けていても、共通の型定義やテストデータを誰かが書き換えれば、マージのときにコンフリクトとして現れます。共有部分の更新は1つのセッションに寄せておくと、後から差分をほどく手間が減ります。担当の境目が読みにくいファイルが出てきたら、並列にせず順番に回すほうが安全です。
同時に何個まで走らせられますか?
一律の数はありません。決まる要因はタスクの独立度と、手元のマシンの余裕です。レビュー待ちの差分をどこまで許すかが目安になります。その範囲を超えたら新しいセッションは足さず、統合を先に進めます。同じマシンで3つ同時にビルドとテストを回すと、一時的に重くなることがあります。
並列セッションのモデル呼び出し先は、どうそろえますか?
接続先を1つに決めておけば、セッションごとに設定を書き分ける必要はありません。OpenAI SDK なら base URL を https://api.mixroute.ai/v1 に向ければ、モデル名はそのまま使えます。Anthropic SDK の場合は base_url を https://api.mixroute.ai(/v1 は付けません)にします。worktree は作業ディレクトリを分ける仕組みで、接続先を分ける仕組みではないので、どのセッションも同じキーと同じ URL を参照する形で問題ありません。