Claude Code 記憶:放在哪、範圍多大、怎麼檢查
Claude Code 的記憶有兩套,放的位置不一樣。一套是您手寫的 CLAUDE.md,照受管理原則、使用者、專案、本機分成四層,各層路徑不同。另一套是自動記憶,由 Claude 依您的更正和偏好自己寫下,存在家目錄裡每個專案專屬的目錄 ~/.claude/projects/<project>/memory/,啟動時只先讀 MEMORY.md 這個索引,主題檔等需要時才讀。想知道這次工作階段到底讀了哪些檔案,在互動工作階段輸入 /context,Memory files 清單會一一列出;出現在清單上的才會生效,沒有的改再多也沒用。
Claude Code 的記憶分成哪兩套?
分法是看誰維護、涵蓋範圍多大,兩套每次工作階段都會載入。CLAUDE.md 歸您,內容是指示與規則;自動記憶歸 Claude,內容是它從您的更正與偏好整理出的筆記。同一件事昨天講過、今天還得重講,多半不是記憶壞了,是那件事兩套都沒寫進去。
誰寫的,決定誰維護
要放哪一套,就看誰該負責讓它保持正確。團隊的建置指令、資料夾慣例、架構決策給人寫,因為這些要進版控、要能被程式碼審查改到。至於「這位使用者偏好哪種寫法」「上次我糾正過它哪裡」,讓 Claude 在對話裡自己累積,您通常是事後才打開來確認它記了什麼。
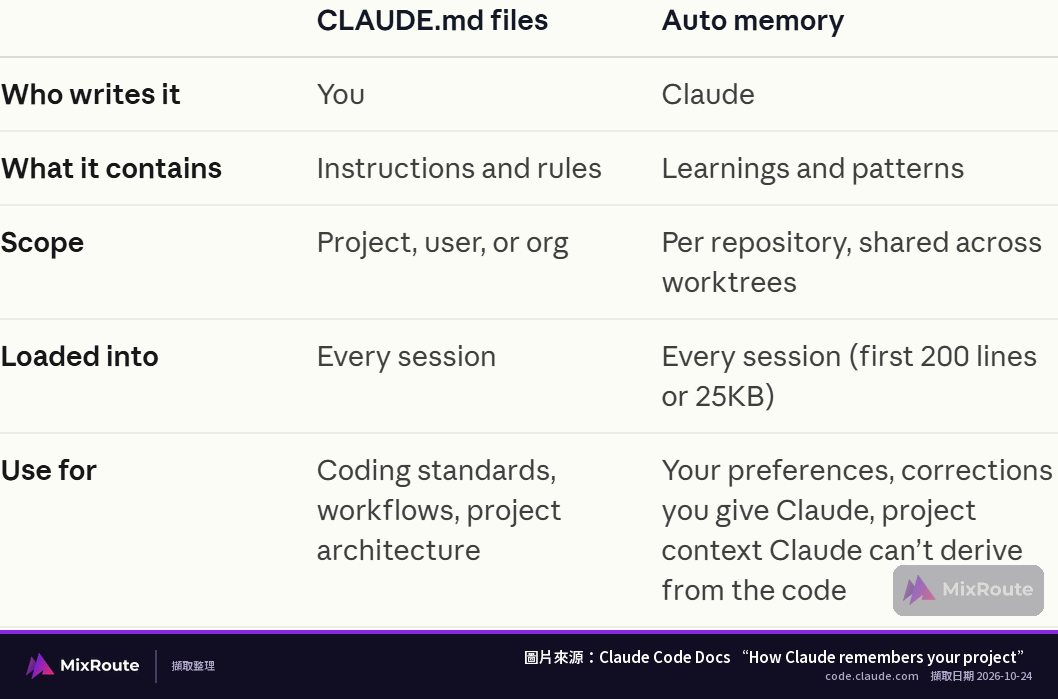
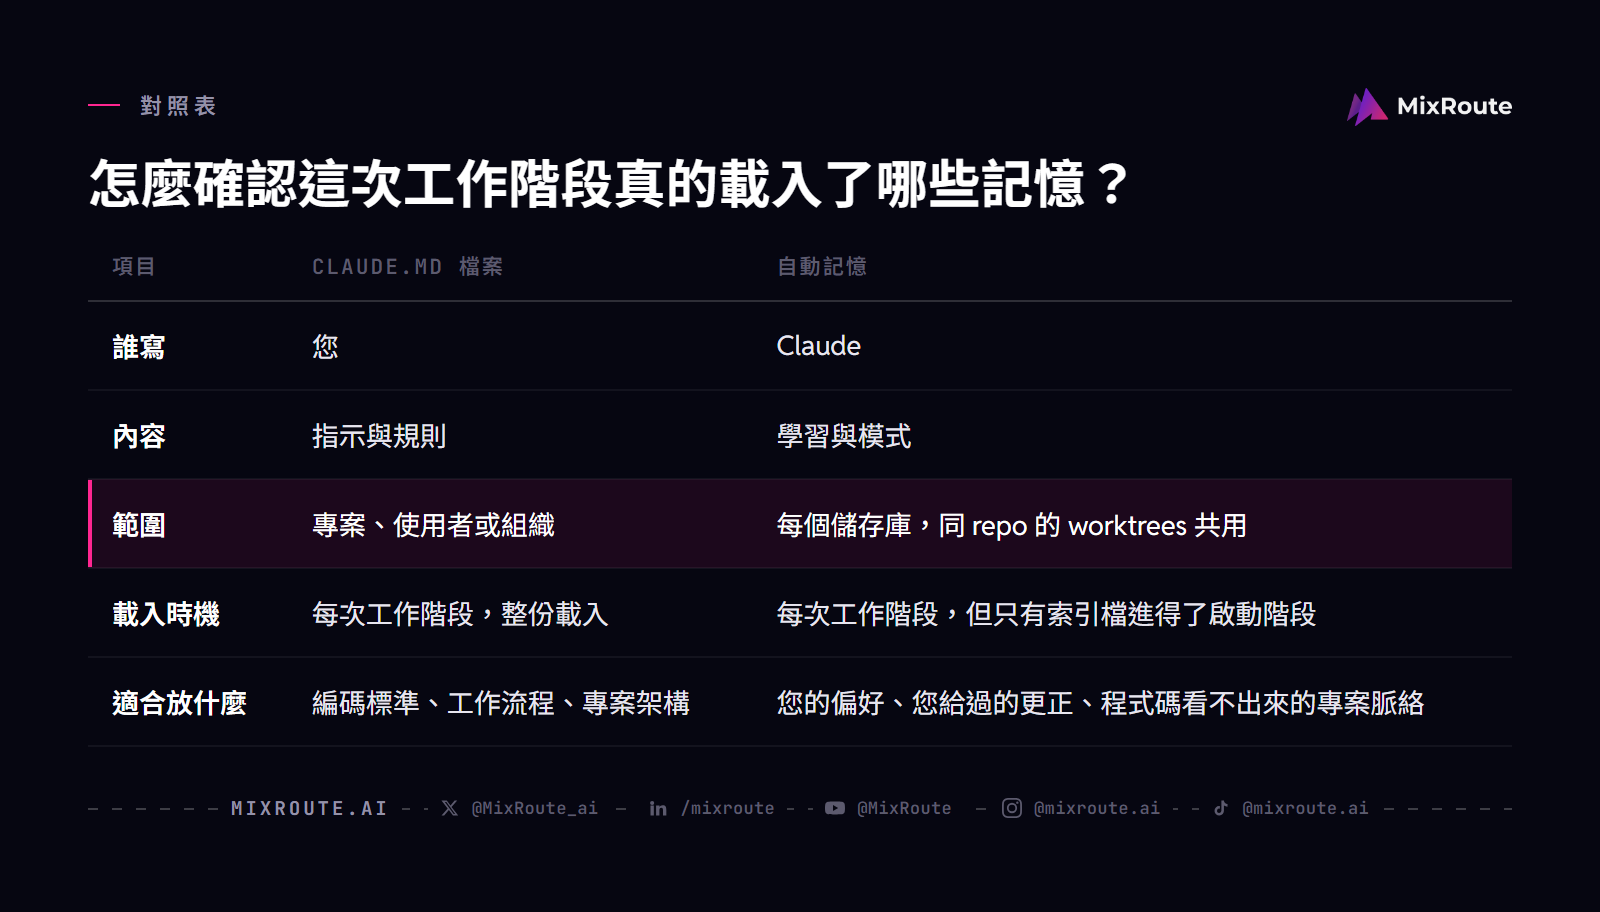
兩套記憶的分工對照
| 項目 | CLAUDE.md 檔案 | 自動記憶 |
|---|---|---|
| 誰寫 | 您 | Claude |
| 內容 | 指示與規則 | 學習與模式 |
| 範圍 | 專案、使用者或組織 | 每個儲存庫,同 repo 的 worktrees 共用 |
| 載入時機 | 每次工作階段,整份載入 | 每次工作階段,但只有索引檔進得了啟動階段 |
| 適合放什麼 | 編碼標準、工作流程、專案架構 | 您的偏好、您給過的更正、程式碼看不出來的專案脈絡 |
啟動時兩者都會被讀,但進到上下文的完整程度不同。CLAUDE.md 是整份進去,自動記憶只有索引檔在第一輪就定位。
什麼時候該加進 CLAUDE.md
這幾種情況就是該寫的時機:Claude 同一個錯犯第二次;程式碼審查抓到它違反這個專案本來就有的慣例;上個工作階段的更正您又打了一遍。新人得先知道同樣的背景才上得了手,也算同一種訊號。更正留在對話裡,下個工作階段就消失;寫成檔案,下次才讀得到。
每一層記憶放在哪個檔案,範圍有多大?
CLAUDE.md 依範圍由寬到窄分成四層:受管理原則、使用者指令、專案指令、本機指令,路徑和共享範圍列在下表。只要工作目錄或它的上層有這組 CLAUDE.md 系列檔案,Claude 會優先讀它們。自動記憶不在這裡,它放在該專案專屬的記憶目錄,和 CLAUDE.md 是兩套分開的東西。
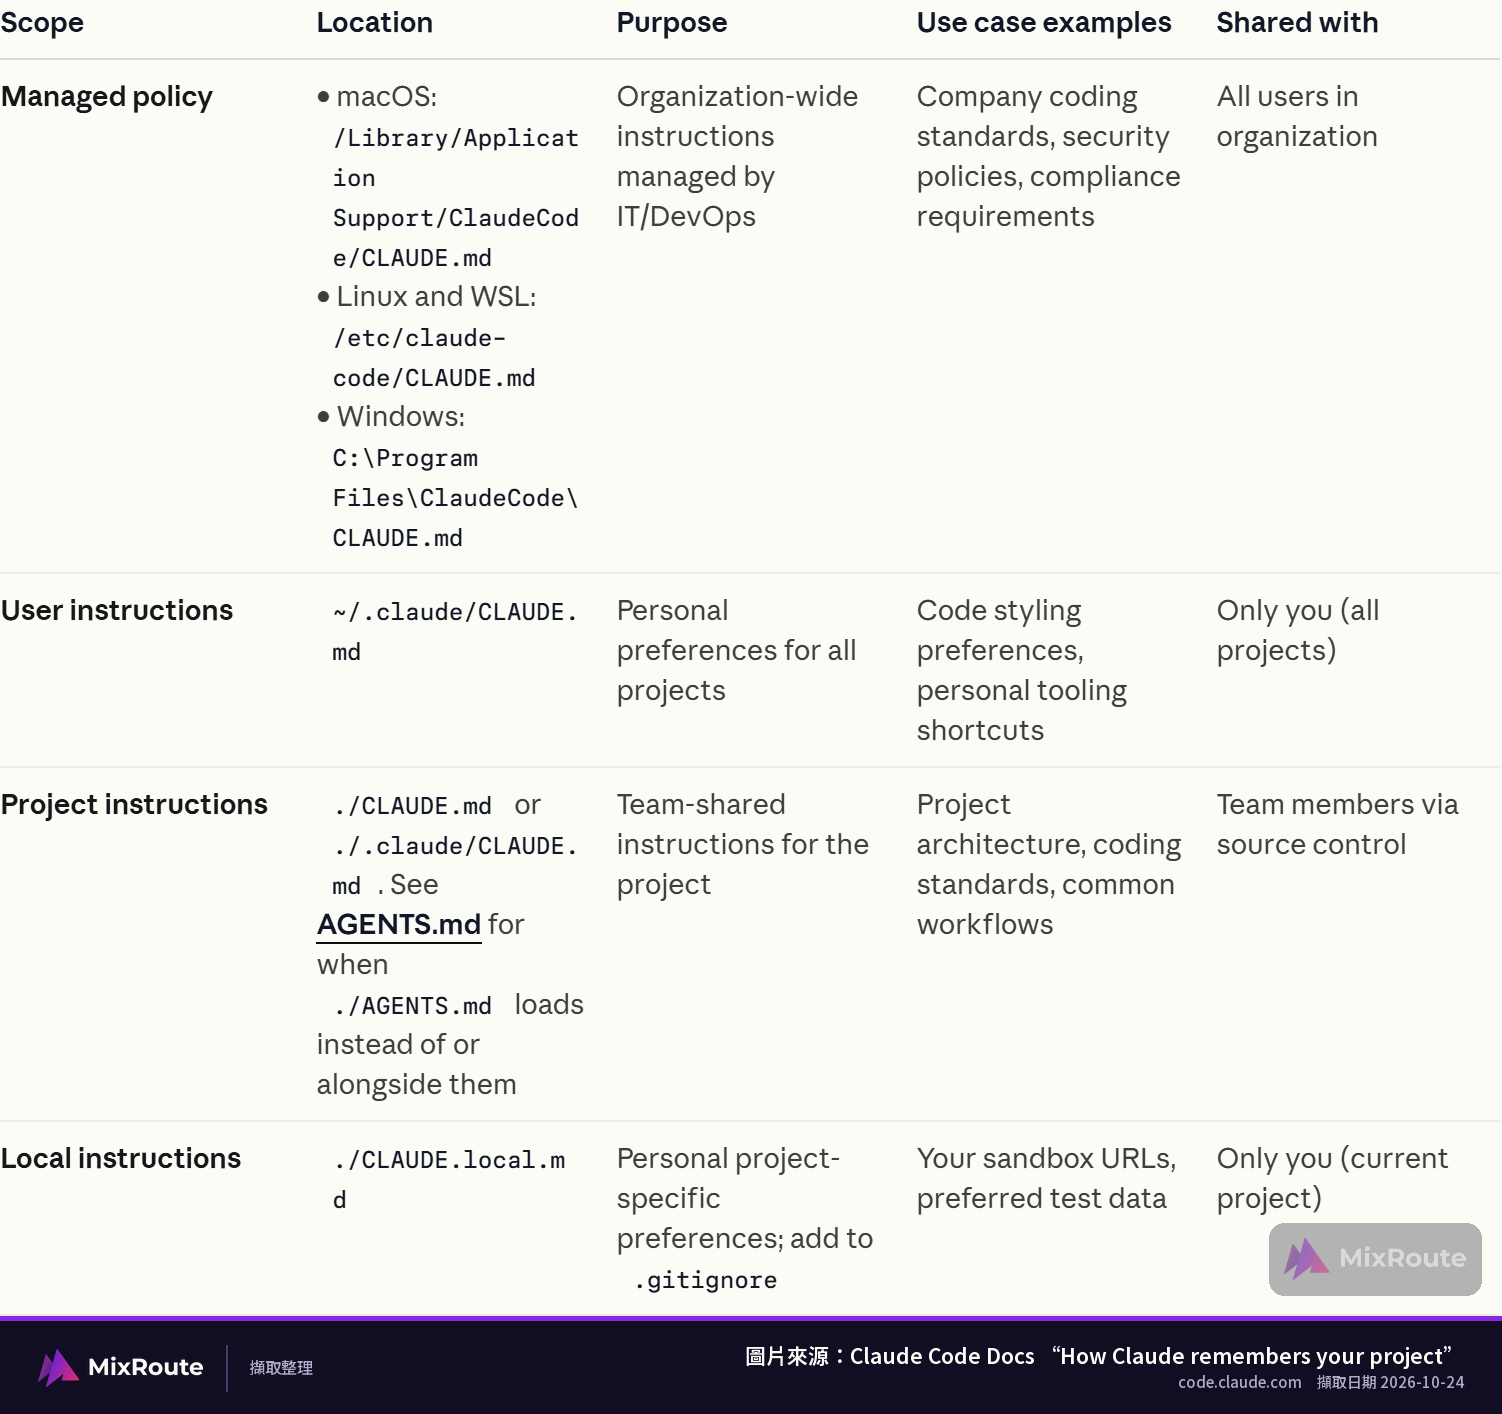
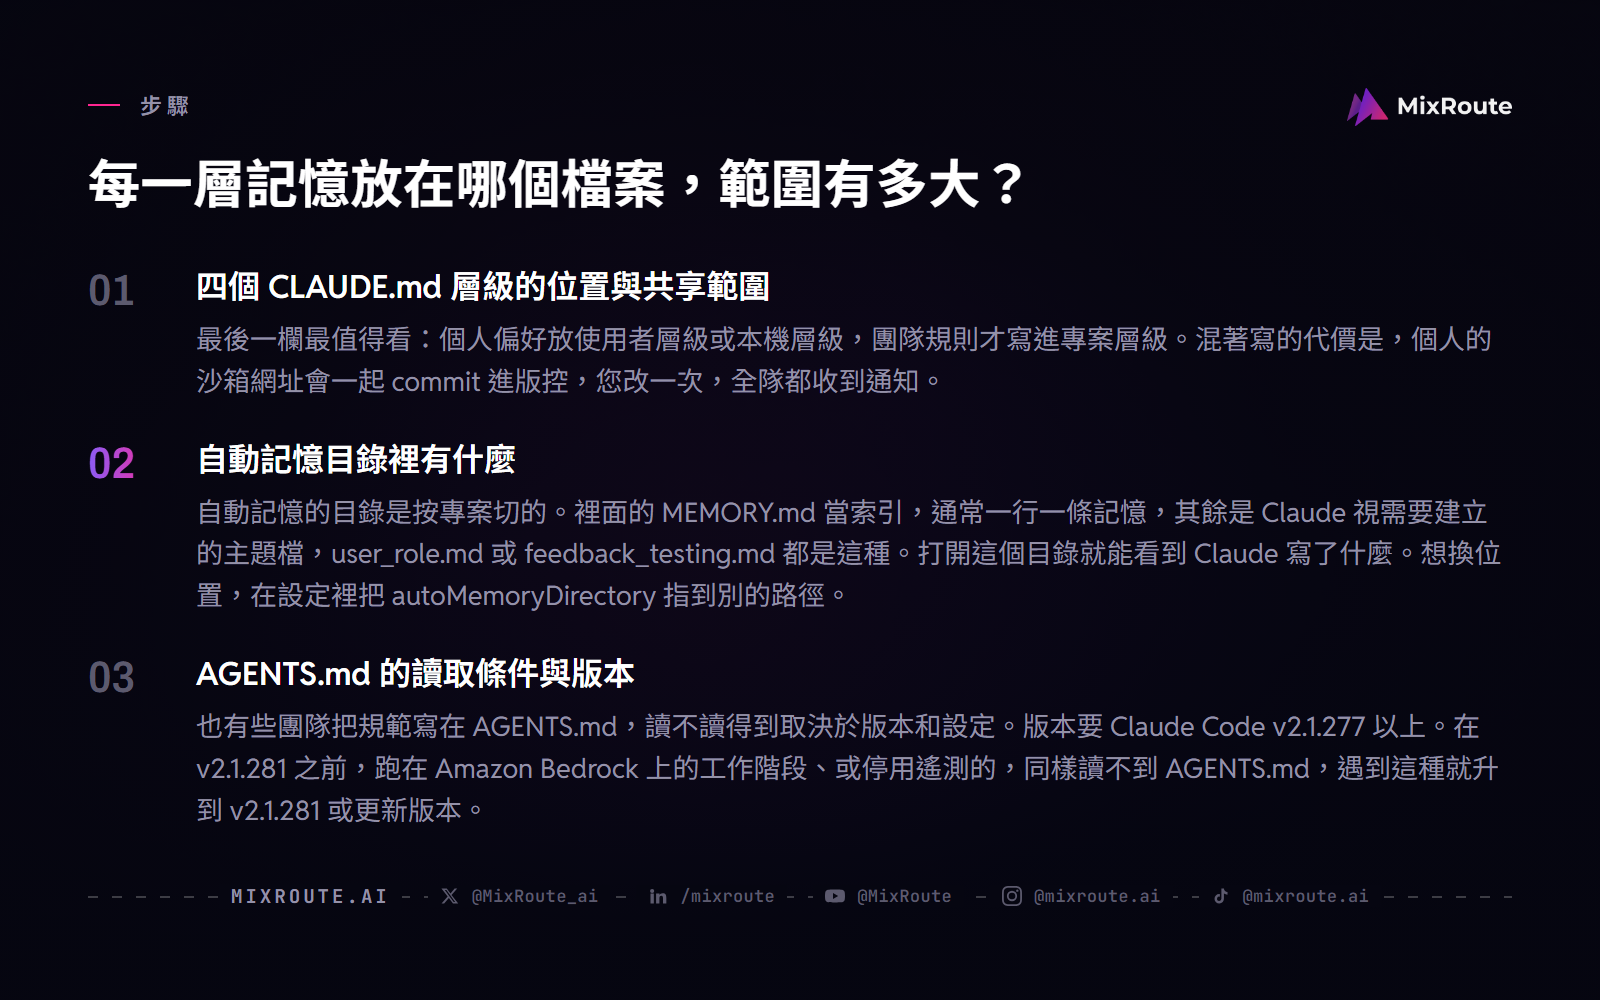
四個 CLAUDE.md 層級的位置與共享範圍
| 層級 | 位置 | 用途 | 共享對象 |
|---|---|---|---|
| 受管理原則 | macOS:/Library/Application Support/ClaudeCode/CLAUDE.md;Linux 與 WSL:/etc/claude-code/CLAUDE.md;Windows:C:\Program Files\ClaudeCode\CLAUDE.md | 組織層級指令,由 IT 或 DevOps 透過設定管理系統部署 | 組織內所有使用者 |
| 使用者指令 | ~/.claude/CLAUDE.md |
跨專案的個人偏好,例如慣用的套件管理器與程式碼風格 | 只有您,所有專案 |
| 專案指令 | ./CLAUDE.md 或 ./.claude/CLAUDE.md |
團隊共用的專案架構、編碼標準與常見工作流程 | 透過版控的團隊成員 |
| 本機指令 | ./CLAUDE.local.md |
個人在這個專案裡的偏好,例如沙箱網址與慣用測試資料,建議加進 .gitignore | 只有您,目前專案 |
最後一欄最值得看:個人偏好放使用者層級或本機層級,團隊規則才寫進專案層級。混著寫的代價是,個人的沙箱網址會一起 commit 進版控,您改一次,全隊都收到通知。
自動記憶目錄裡有什麼
自動記憶的目錄是按專案切的。裡面的 MEMORY.md 當索引,通常一行一條記憶,其餘是 Claude 視需要建立的主題檔,user_role.md 或 feedback_testing.md 都是這種。打開這個目錄就能看到 Claude 寫了什麼。想換位置,在設定裡把 autoMemoryDirectory 指到別的路徑。
AGENTS.md 的讀取條件與版本
也有些團隊把規範寫在 AGENTS.md,讀不讀得到取決於版本和設定。版本要 Claude Code v2.1.277 以上。在 v2.1.281 之前,跑在 Amazon Bedrock 上的工作階段、或停用遙測的,同樣讀不到 AGENTS.md,遇到這種就升到 v2.1.281 或更新版本。
決定是否取代 AGENTS.md,只看工作目錄或上層那幾個檔案,家目錄裡的那一份不列入計算。要讓兩者並列讀取,把 Project instructions 設成 claude-md-and-agents-md,Claude 會在每個目錄先讀 CLAUDE.md、再讀 AGENTS.md,已載入過的 AGENTS.md 不會再讀第二次。
怎麼確認這次工作階段真的載入了哪些記憶?
執行 /context,Memory files 清單會列出啟動時載入的 CLAUDE.md,專案與本機那幾份都會出現。不在清單上,Claude 就看不到該檔案,內容再怎麼改也沒用。/memory 是另一個入口:能開啟記憶檔、直接編輯,也能切換自動記憶的開關。
用 /context 核對啟動載入清單
清單和預期不符,先看位置。使用者層級放家目錄的 .claude 底下;專案層級放工作目錄或它的上層;本機層級要和專案檔同一個根目錄。位置正確卻還是沒出現,再查設定是不是把它排除掉了,claudeMdExcludes 就是依樣式排除特定檔案或整個規則目錄。
子目錄與路徑範圍規則的按需載入
子目錄裡的 CLAUDE.md 屬於按需載入,所以不會出現在 Memory files 清單。Claude 實際讀到那個子目錄的檔案時才會把它帶進來,此時終端機會多一行 Loaded 加路徑。想驗證剛建好的子目錄 CLAUDE.md,從終端機自己建檔,接著請 Claude 去讀該子目錄裡的檔案,這一行就會出現。
讀不到時的檢查順序
三關依序是位置、設定、內容。位置沒問題,打開 /config 的設定面板,確認 Project instructions 是不是被設成 claude-md 或 managed-only;面板裡如果沒有這個選項,這個工作階段就不載入 AGENTS.md。內容最後才懷疑:指令不夠具體、兩個檔案方向不同、或您的規則和 Claude Code 內建的提交與 PR 指引相衝,都會讓它看起來像沒讀到。
哪些內容會跨工作階段留下來,哪些不會?
兩套都能跨工作階段,方式和時機不一樣。CLAUDE.md 的內容每次啟動都重讀一次,改過就長期有效。自動記憶是把工作階段裡的觀察寫進專案的記憶目錄,下次啟動先讀 MEMORY.md 索引,其餘主題檔要等 Claude 用檔案工具去讀才會進上下文。
一個跨工作階段留下來的例子
在專案 CLAUDE.md 寫下「提交前執行 npm test」,隔天開新工作階段這條規則依然在,原因是它每次啟動都被重新讀取。同一段對話中 Claude 也會自己記下您給的一則更正,寫進該專案的記憶目錄。隔天啟動時進到上下文的是 MEMORY.md 索引,主題檔還沒進來,要等需要時才讀。兩件事都留了下來,一個立刻生效,一個等被叫到。
MEMORY.md 的 200 行與 25KB 上限
這條上限只管 MEMORY.md,前 200 行或前 25KB,哪個先到算哪個。超出範圍的內容啟動時不載入,新工作階段自然看不到,Claude 會把細節挪去主題檔,索引才維持精簡。
200 行這個數字管不到 CLAUDE.md,不過它也有上限:Claude Code 完整載入的 CLAUDE.md 上限是 4 MiB,超過就跳過。檔案越長,佔用的上下文越多,遵守度跟著變差。
不會自動留下的部分
對話本身不會變成跨工作階段的記憶,只有寫進檔案的內容才算。Claude 也不是每場對話都記,它得判斷某件事對之後的對話有用才動筆,所以「我上次說過」和「它上次記下來」是兩回事。索引之外的主題檔要等它主動讀,超過上限的索引內容在啟動時就被截掉。
寫進 CLAUDE.md 的內容要具體到什麼程度?
寫成可以驗證的動作最有作用。「使用 2 空格縮排」比「正確格式化程式碼」清楚;「提交前執行 npm test」比「測試您的變更」清楚;「API 處理程式放在 src/api/handlers/」比「保持檔案整齊」清楚。每個 CLAUDE.md 以 200 行以內為目標,太長會多吃上下文,遵守度也下滑。
把指令寫成可驗證的動作
標準很簡單:這條指令有沒有留下能檢查的痕跡。寫完之後問自己,如果 Claude 照做,我從哪個檔案、哪段指令輸出或哪次測試結果看得出來?答得出來就留;答不出來的大多只是期待,得改成具體規則。分組也別忘了,用標題和項目符號分段,比一整塊密集文字好跟。
200 行、標題分組與衝突檢查
檔案會越長越大,也會彼此矛盾。兩個檔案對同一件事給了不同指示,Claude 可能任選一個,行為看起來就很隨機。定期巡一遍專案檔、子目錄裡的巢狀檔和 .claude/rules/,把過時或衝突的指令刪掉。也可以請 Claude 跑一次提示詞審計,把衝突的地方挑出來。
把部分檔案的規則移到 .claude/rules/
如果一條規則只對一部分程式碼重要,搬到 .claude/rules/ 比較省。加了 paths frontmatter 的規則,只在 Claude 處理符合 glob 的檔案時載入,像只涵蓋 src/api/**/*.ts 的 API 慣例就是這樣。沒有 paths 的規則檔在啟動時就載入,用 @ 匯入的檔案同樣在啟動時載入,所以匯入只是讓長檔案好整理,佔的上下文並不會變少。規則穩定下來之後,也可以延伸閱讀AI 協作流程,讓這些規則真的進到日常開發裡。
自動記憶為什麼只認一個專案?
這是預設行為。自動記憶的單位是 git 儲存庫,同一個 repo 的 worktrees 共用同一份,在專案裡切分支或另開 worktree 都還看得到;換到別的儲存庫,這份筆記不會跟著過去。個人偏好若要跨專案沿用,寫在使用者層級那份。
以 git 儲存庫為單位
目錄路徑裡的 <project> 從 git 儲存庫推導而來;沒有版控的目錄則取專案根目錄。這帶來兩個結果:同一個 repo 的所有 worktree 共用一份自動記憶;專案目錄搬家或改了 repo 歸屬,記憶的落點也跟著變。
跨專案的個人層級寫在哪
原生支援跨專案的是使用者層級,但它得靠您手寫維護,自動記憶不會往那裡寫。要的是「不管在哪個專案,Claude 都知道我偏好哪種寫法」,就把那幾條放進使用者層級的檔案。要的是自動累積,就得接受它以 repo 為界。
為什麼會覺得「它換專案就忘了」
在 A 專案聊出來的偏好留在 A 的自動記憶,到了 B 專案又重講一遍,兩份筆記各自完整,卻不會合出一個跨專案的結論。碰到這種狀況,先看這條偏好是不是通用規則,是就搬到使用者層級;只有跟這個 repo 綁死的事,才留在專案的記憶裡。
檢查完記憶之後,下一步做什麼?
下一步最實際的做法,就是把每次都要重講的工作流程、建置指令和您給過的更正寫成記憶。寫進 CLAUDE.md 的變成規則,交給自動記憶的變成專案筆記,下個工作階段就能從上次的位置接著做。至於模型請求要經過哪一層、那一層留下什麼紀錄,是另一個獨立的決定。
把重複交代的流程變成記憶
檢查完通常會得到兩份清單。一份是「我每次都必須說」的事,放進 CLAUDE.md 或使用者層級;一份是「上次我糾正過它」的事,交給自動記憶接手。做完這一輪,同一段說明下個工作階段就不必再打一遍。
請求層留下的紀錄是另一個決定
本機的記憶,和請求送出後留下的紀錄,是兩層不同的東西;不要拿記憶檔案去推測上游留了什麼。以 MixRoute 為例,閘道不記錄使用者輸入文字、AI 輸出回應、對話內容、圖片或檔案內容與個人身分資訊。系統 log 保留 7 天,欄位是時間戳、token 數、模型名稱與回應狀態,用於計費與排錯。某個請求在上游留下什麼,要問的是那一層的政策。
決定模型請求要走哪一層之後,比較各方案的計費方式再選定要用哪一個,會比先開通再回頭對帳清楚。
FAQ
Claude Code 的記憶存在哪裡?
CLAUDE.md 和自動記憶放不同地方。您手寫的 CLAUDE.md 依層級分在家目錄、專案根目錄、專案本機三處,此外還有一份受管理原則由 IT 或 DevOps 部署。自動記憶則是 Claude 自己寫的筆記,存在該專案專屬的記憶目錄,跟著儲存庫跑。這次到底讀到哪幾份,在互動工作階段執行 /context 看清單最快。
CLAUDE.md 和自動記憶差在哪裡?
誰寫的不同,範圍也不同。CLAUDE.md 由您撰寫,內容是指示與規則,可以落在專案、使用者或組織層級。自動記憶是 Claude 依您的更正與偏好寫的筆記,單位是儲存庫,同一個 repo 的 worktrees 共用一份。兩套每次工作階段都會載入,但完整程度有差:CLAUDE.md 整份進上下文,自動記憶先進來的只有索引。
MEMORY.md 是什麼,載入有上限嗎?
MEMORY.md 是自動記憶目錄裡的索引,通常一行一條記憶。上限是前 200 行或前 25KB,哪個先到算哪個,超過的部分啟動時不會進上下文。這條上限只管 MEMORY.md;主題檔本來就不在啟動時載入,Claude 需要時才用檔案工具去讀,索引塞太滿時它也會把細節往外搬。
怎麼確認這次工作階段真的載入了哪些記憶?
在互動工作階段執行 /context。Memory files 清單只列啟動時載入的檔案,子目錄裡按需載入的 CLAUDE.md 不會出現,要等 Claude 讀到那個目錄才被帶進來。清單有缺,先看 claudeMdExcludes 是否排除了該路徑,再確認位置:本機那一份要和專案檔同一個根目錄。
自動記憶會跨專案嗎?
預設不會。自動記憶的單位是 git 儲存庫,同一個 repo 的 worktrees 共用一份,換到另一個儲存庫就各記各的。要跨專案沿用的個人偏好,得寫在使用者層級,那一層靠自己維護,自動記憶不會往那裡寫。它同時是機器本地的,除非您自己同步那個目錄,否則不會跨機器或雲端環境共用。
AGENTS.md 什麼時候會被讀?
取決於工作目錄裡有沒有 CLAUDE.md 系列檔案。工作目錄或其上層若有這幾個檔案(家目錄那份不算),Claude 讀它們而不讀 AGENTS.md,除非把 Project instructions 設成 claude-md-and-agents-md。版本也要顧:v2.1.277 以上才支援,v2.1.281 之前部分工作階段讀不到,遇到就升上去。
自動記憶可以關掉嗎?
可以。在設定裡把 autoMemoryEnabled 設成 false 就停用,/memory 也能直接切換開關。停用之後 Claude 不再自己寫筆記,CLAUDE.md 的載入完全不受影響,您手寫的規則照樣每次工作階段生效。要讓某些規則一定生效,寫進 CLAUDE.md 比較穩;自動記憶記不記,是 Claude 自己判斷。
CLAUDE.md 寫多長、寫多細才好?
每個檔案以 200 行以內為目標,指令要寫成可驗證的動作,例如「提交前執行 npm test」而不是「測試您的變更」。只對部分檔案重要的規則,放進 .claude/rules/ 的路徑範圍規則;加了 paths frontmatter,才會只在處理符合 glob 的檔案時載入。分組用標題與項目符號,並定期清掉衝突的指令,兩個檔案方向不同時,Claude 可能任選一個。