Claude Code 记忆:位置、作用域与查看清理方法
CLAUDE.md 改了,Claude 却还是照老样子做,先用两个命令查:/context 列出这次会话真正加载了哪些记忆文件,/memory 打开、编辑和删除具体条目。Claude Code 的记忆分两类。一类是你自己写的 CLAUDE.md 指令文件,按作用域分成组织托管、用户、项目和本地四层。另一类是 Claude 根据你的更正和偏好自己写下的自动记忆,按仓库收在 ~/.claude/projects/<project>/memory/,入口是 MEMORY.md 索引。跨会话留得住的是规则、偏好和决策背景,会变的事实留下来也不牢。
Claude Code 的记忆分几类,分别存在哪里?
记忆分布在三处:四层指令文件、一份路径范围规则,以及一个按仓库存放的自动记忆目录。你写的 CLAUDE.md 覆盖组织托管、用户、项目和本地四个作用域。Claude 自己写的自动记忆,按仓库单独收在一个 memory 目录里。.claude/rules/ 下带 paths 声明的规则,只在 Claude 处理到匹配文件时才加载。
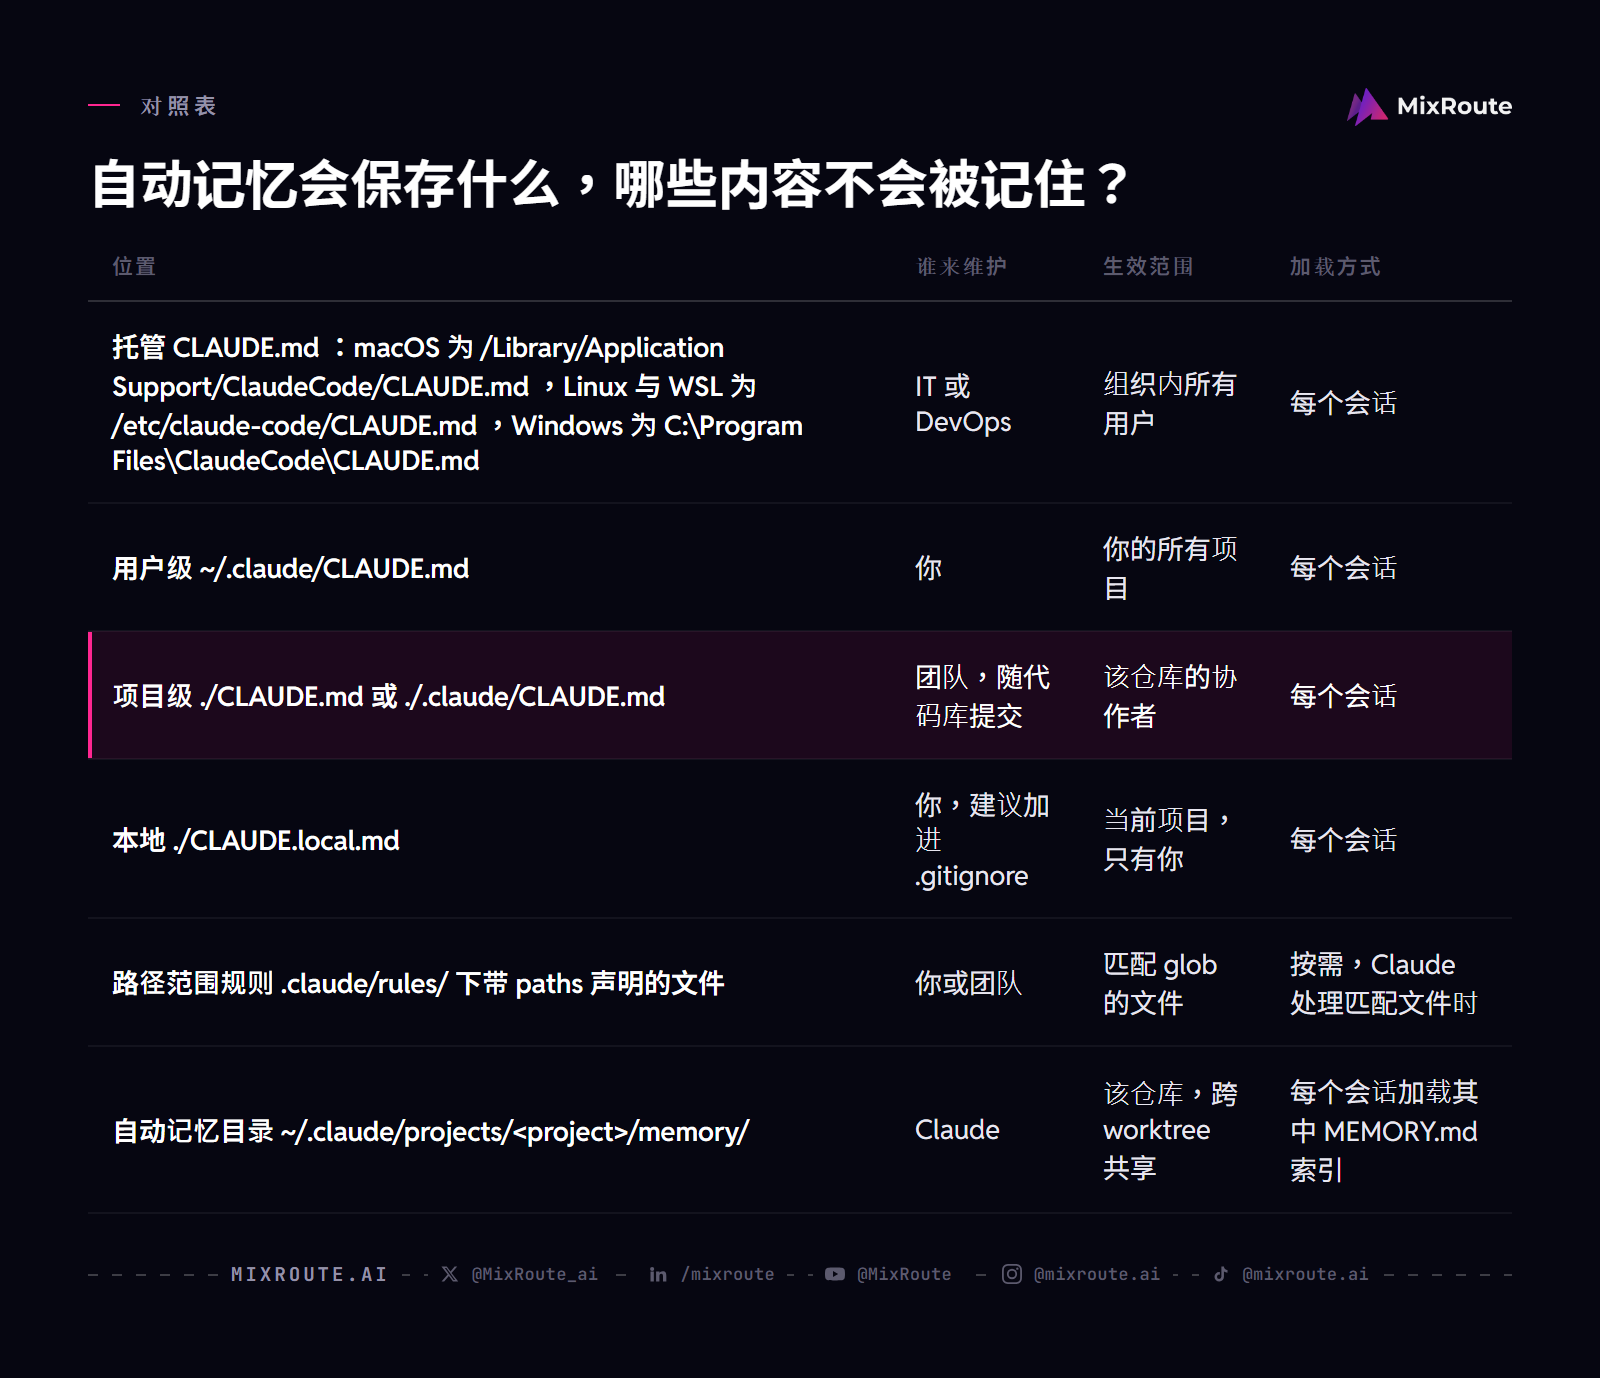
不少“配置没生效”,其实是文件放错了层。同一条规则放在用户级,对所有项目生效;放在项目级,只影响这一个仓库。
| 位置 | 谁来维护 | 生效范围 | 加载方式 |
|---|---|---|---|
托管 CLAUDE.md:macOS 为 /Library/Application Support/ClaudeCode/CLAUDE.md,Linux 与 WSL 为 /etc/claude-code/CLAUDE.md,Windows 为 C:\Program Files\ClaudeCode\CLAUDE.md |
IT 或 DevOps | 组织内所有用户 | 每个会话 |
用户级 ~/.claude/CLAUDE.md |
你 | 你的所有项目 | 每个会话 |
项目级 ./CLAUDE.md 或 ./.claude/CLAUDE.md |
团队,随代码库提交 | 该仓库的协作者 | 每个会话 |
本地 ./CLAUDE.local.md |
你,建议加进 .gitignore |
当前项目,只有你 | 每个会话 |
路径范围规则 .claude/rules/ 下带 paths 声明的文件 |
你或团队 | 匹配 glob 的文件 | 按需,Claude 处理匹配文件时 |
自动记忆目录 ~/.claude/projects/<project>/memory/ |
Claude | 该仓库,跨 worktree 共享 | 每个会话加载其中 MEMORY.md 索引 |
你写的指令文件,从组织到本地共四层
托管位置放公司的编码标准、安全要求和合规提醒,由 IT 或 DevOps 用配置管理系统统一部署。用户级放你个人的代码风格偏好和常用命令。项目级随代码库提交给团队,放项目架构和常见工作流。本地级放沙箱地址、测试数据这类只属于你的东西。
一条规则放哪层,看它会不会跟着代码库走:团队约定进项目级,个人习惯进用户级,只在这一个仓库成立的偏好进本地级。如果在另一个仓库里第二次被指出同一个习惯,说明那条规则放低了,挪到用户级更省事。
自动记忆按仓库存放,入口是 MEMORY.md 索引
目录里的 MEMORY.md 是索引,一个记忆一行,会话开始时自动加载。其余是主题文件,比如 user_role.md 或 feedback_testing.md,一个文件一条记忆,由 Claude 自己创建。想把记忆挪到别处,用 autoMemoryDirectory 设置指定,官方文档给的例子是 ~/my-custom-memory-dir。
同一个仓库的多个 worktree 和子目录共用一个自动记忆目录。官方文档的目录示例里,user_role.md 这类记录个人背景的文件也放在这个按仓库划分的目录下。需要明确、可审阅地跨项目共用的偏好,写进用户级 CLAUDE.md 更稳妥,自动记忆不是跨项目存储。
带 paths 声明的 .claude/rules/ 规则,只在匹配文件出现时加载
规则文件用 frontmatter 的 paths 声明 glob,比如 src/api/**/*.ts,Claude 处理到匹配文件时才加载。CLAUDE.md 则是一进来就在每个会话里。只对某个目录成立的规范放在这里,能省下不少上下文。
CLAUDE.md 和自动记忆有什么区别?
两者在五个地方不同:谁编写、包含什么、作用域多大、怎么加载、拿来做什么。简单说,你写规则,它记偏好和更正。日常最容易踩坑的是加载方式:CLAUDE.md 每次会话整份进来,自动记忆每次只进来一份索引。
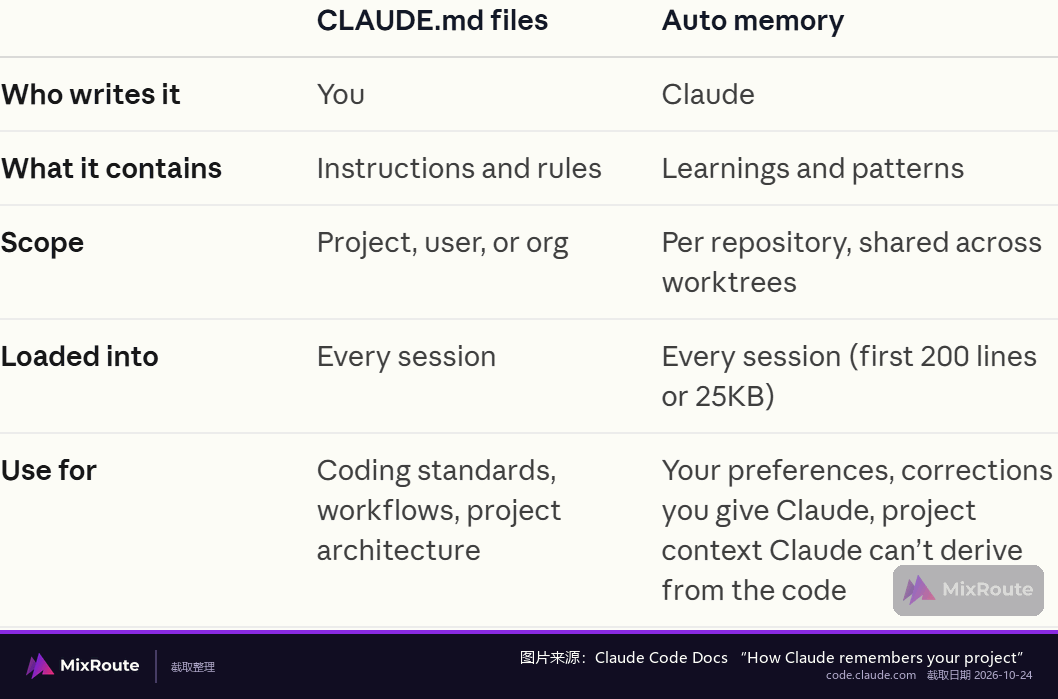
| 对比项 | CLAUDE.md 文件 | 自动记忆 |
|---|---|---|
| 谁编写 | 你 | Claude |
| 包含内容 | 指令和规则 | 它学到的模式和你的偏好 |
| 作用域 | 组织、用户、项目或本地 | 每个存储库,跨 worktree 共享 |
| 加载方式 | 每个会话完整加载 | 每个会话只加载 MEMORY.md 索引的前 200 行或 25KB |
| 适合放 | 编码标准、工作流、项目架构 | 你的偏好、你给的更正、Claude 无法从代码推导的项目背景 |
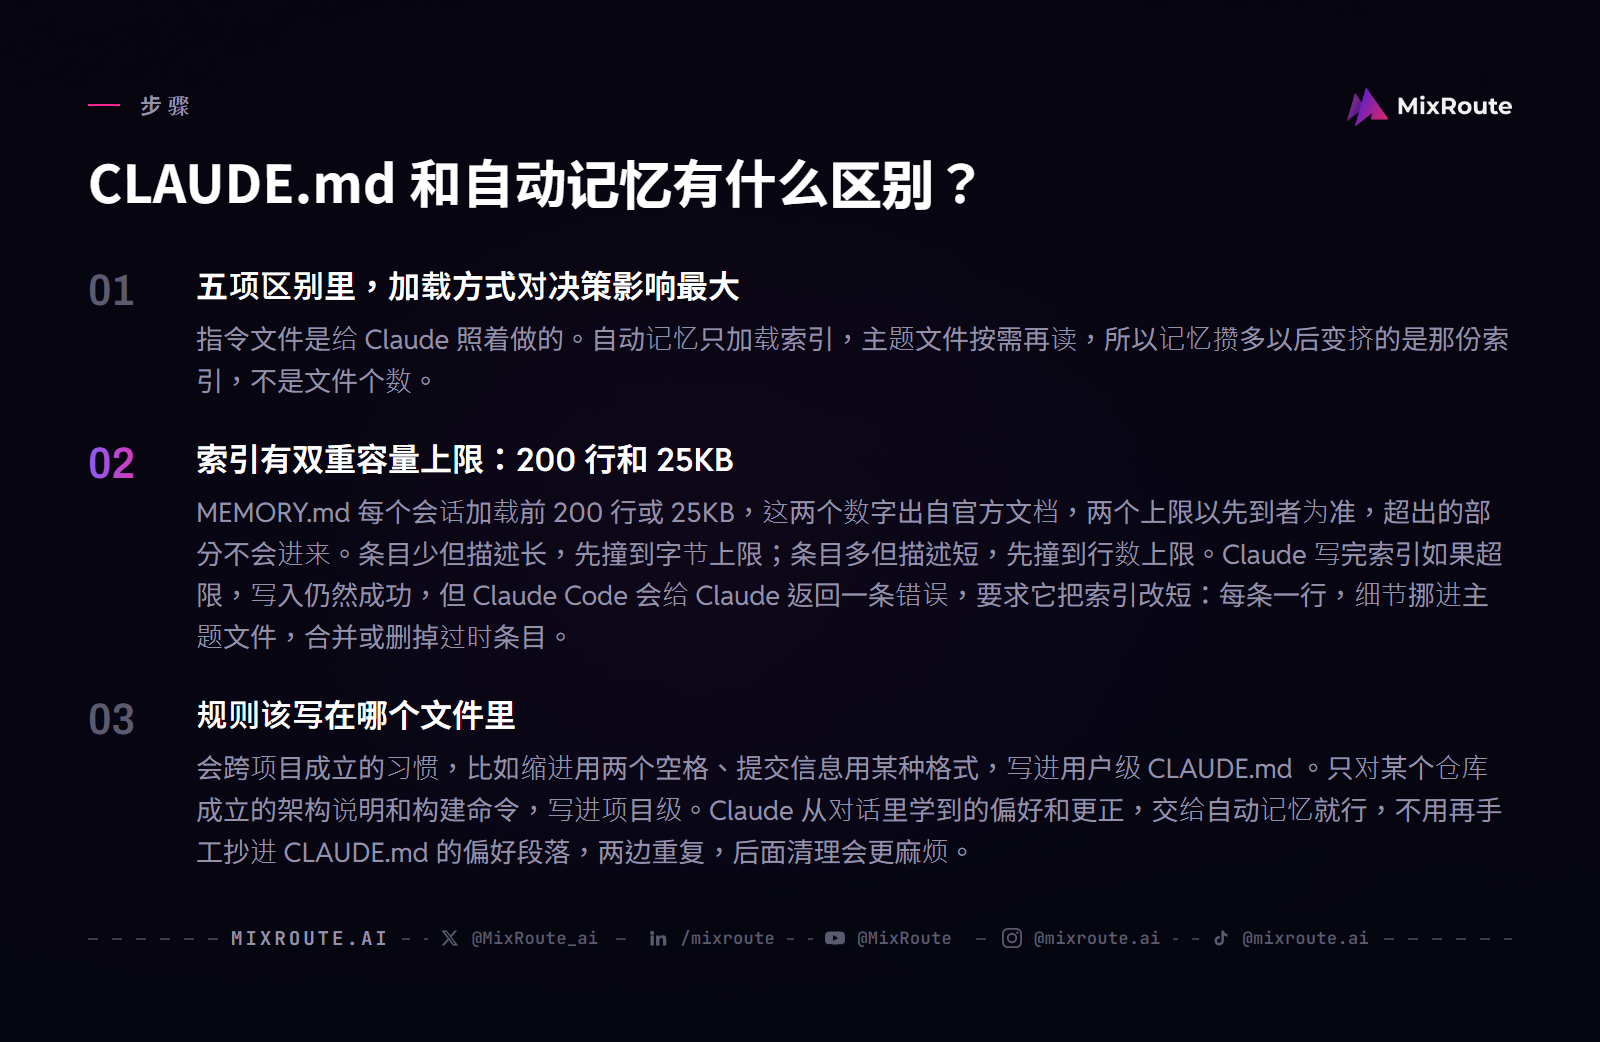
五项区别里,加载方式对决策影响最大
指令文件是给 Claude 照着做的。自动记忆只加载索引,主题文件按需再读,所以记忆攒多以后变挤的是那份索引,不是文件个数。
指令文件本身也有大小限制。官方文档写明,CLAUDE.md 完整加载最多 4 MiB,超过的文件会被跳过。把一整份规范贴进 CLAUDE.md,可能换来一份根本读不进去的文件。
索引有双重容量上限:200 行和 25KB
MEMORY.md 每个会话加载前 200 行或 25KB,这两个数字出自官方文档,两个上限以先到者为准,超出的部分不会进来。条目少但描述长,先撞到字节上限;条目多但描述短,先撞到行数上限。Claude 写完索引如果超限,写入仍然成功,但 Claude Code 会给 Claude 返回一条错误,要求它把索引改短:每条一行,细节挪进主题文件,合并或删掉过时条目。
规则该写在哪个文件里
会跨项目成立的习惯,比如缩进用两个空格、提交信息用某种格式,写进用户级 CLAUDE.md。只对某个仓库成立的架构说明和构建命令,写进项目级。Claude 从对话里学到的偏好和更正,交给自动记忆就行,不用再手工抄进 CLAUDE.md 的偏好段落,两边重复,后面清理会更麻烦。
自动记忆会保存什么,哪些内容不会被记住?
自动记忆只收四类内容。标准是这条信息能不能从当前项目状态推导出来:代码、目录结构或 git 历史里直接读得到的,它不收;只存在你脑子里或外部系统里的,才值得记。
| 类型 | 记什么 | 什么时候会被写下来 |
|---|---|---|
user |
你的角色、专长和工作偏好 | 你说自己写了十年 Go 但第一次碰 React |
feedback |
你给 Claude 的更正,以及你确认过的做法 | 你说提交前必须先跑 lint,或认可了某个非显而易见的做法 |
project |
进行中的工作、截止日期、无法从代码或 git 历史推导的决策 | 你在把某个模块迁到新框架,或者解释了某次重写的原因 |
reference |
项目外的信息在哪找,例如问题跟踪器或仪表板 | 你说生产告警面板在这个地址 |
四种类型:user、feedback、project、reference
这四类对应的,是你每次都要重新交代一遍的四种事。user 让你不用反复说明自己的背景,feedback 让做法在多次会话里保持一致,project 留下“为什么这么做”和“什么时候要完成”,reference 存的是指针。
记时间点用绝对日期,“下周二”这类说法到了下次会话就没有意义了。
排除清单:读一遍代码就能拿到的不进记忆
官方的原则是“无法从代码或 git 历史推导”,具体排除这几类:
- 代码模式、惯例和架构
- 文件路径和 Git 历史
- 调试解决方案
CLAUDE.md里已经写过的文档- 当前对话的临时细节
即使你明确要求它记住这些,它也会把你引到其中非显而易见的部分。想让 Claude 记住项目目录结构或接口清单,恰好落在排除范围里。这类信息每次现读一遍更快,成本大概是几毫秒的工具调用、几百 token,属于量级估算而不是实测数字,记下来只会占掉索引里的位置。
为什么把文档搬进记忆不划算
技术规范和设计文档留在代码库的文档目录,记忆里只留决策的原因,下一次排查时最明显。打开索引看到的是“认证中间件重写是因为合规要求”,而不是一份已经过期的接口列表。规范变了就改文档,决策背景基本不会过期。
跨会话能留下什么,哪些内容下次还得重新确认?
留下的是规则、偏好和决策背景;任何会变的事实,留下来都不牢。“提交前先跑 npm run lint”这种更正,下次会话仍然读得到。项目现在用哪个依赖版本,记忆里可能还停在上次看到的状态,动手前当场看一眼更省事。
例子:一条 lint 规则怎么跨过会话
你在某次对话里说,以后提交代码前先跑 npm run lint,上次有人漏了这一步,CI 挂了一整天。这条会被记成 feedback 记忆,通常带三部分:规则本身、原因、适用场景。第二天早上开一个全新会话,启动时进来的只有 MEMORY.md 里指向这条记忆的那一行,完整内容等 Claude 需要时再读。你不用再交代一遍,Claude 在准备提交前会先跑 lint。
每条记忆是一个独立的 Markdown 文件,Claude 会在 frontmatter 的 type 字段里记下它属于四类中的哪一类。
记忆是某个时间点的快照,用之前先看当前状态
反过来的情况更容易踩坑。记忆里写着“项目使用 React 18”,团队上周已经升到 19;记忆里写着认证逻辑在 src/auth/handler.ts,重构之后文件已经搬家。记忆是线索,不是结论。它提到文件路径、函数名或版本号,而你要据此动手时,先看一眼当前状态,成本通常很低,读一次 package.json 就够。
网关侧的记录是另一条线
跨会话留下来的东西不只在本地。团队如果用 MixRoute 把模型请求统一收口,按 MixRoute 文档站的说明,它不记录输入文本、输出回复、对话内容、图片或文件内容以及个人身份信息,只保留时间戳、token 数、model name 和 response status 这类用于计费与排错的运行日志,系统日志保留 7 天。本地记忆文件看本地,请求记录看网关,两边记的东西本来就不一样。
怎么查看、编辑和清理已经保存的记忆?
两个命令加一个检查就够了:/context 看哪些文件真的加载了,/memory 打开和修改具体条目,子目录里的文件另走按需加载。
三步检查流程
- 运行
/context,看 Memory files 列表。该在启动时加载的CLAUDE.md和CLAUDE.local.md如果不在里面,Claude 就看不到它。 - 用
/memory打开文件,改掉写错或已经过期的条目,删掉不再适用的记忆。 - 子目录里的
CLAUDE.md不会出现在这个列表里,它按需加载,加载那一刻终端会打印一行 Loaded 加路径。
想验证一个新建的子目录 CLAUDE.md,从 shell 里创建它,再让 Claude 去读那个子目录里的文件,比让 Claude 自己写更容易判断规则有没有生效。这套流程和日常编码连在一起,另见 Vibe coding 实践。
删除主题文件时同步更新索引
删掉一个主题文件后,把索引里对应的那一行也删掉,索引才是每个会话真正读进去的部分。记忆没有自动过期机制,保存之后除非被手动删除或被后来的记忆覆盖,就会一直留着,所以隔一段时间清一遍是必要的。一条记忆留不留,问一句:删掉它,Claude 的行为会有实质不同吗?
记忆不是对话一结束就落盘
刚说完一条规则,下个会话里却没生效,可能是它根本没被记下来。Claude 不是每个会话都会保存内容,它按这条信息对以后的对话有没有用来决定记不记,说过一遍不等于已经写进了记忆。先用 /memory 看有没有这条,没有就手动补入,或者把规则写进 CLAUDE.md。
团队和组织范围下,哪些记忆文件会生效?
决定读哪些文件的是 Project instructions 这个设置,它取哪一层由四个值控制。个人 CLAUDE.md 突然不生效,常见原因就是这个值被改成了 managed-only。
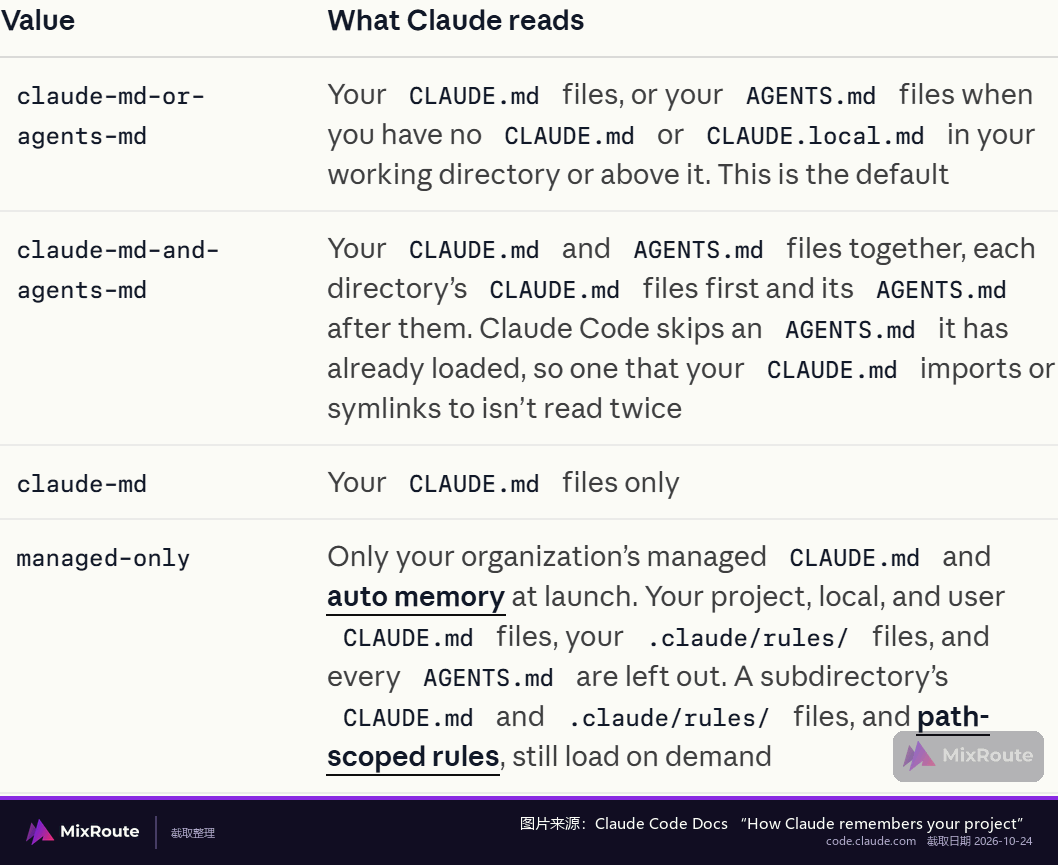
| 取值 | Claude 读取什么 |
|---|---|
claude-md-or-agents-md(默认) |
你的 CLAUDE.md 文件;只有工作目录及其上层都没有 CLAUDE.md 或 CLAUDE.local.md 时才读 AGENTS.md |
claude-md-and-agents-md |
CLAUDE.md 和 AGENTS.md 一起读,同一目录先 CLAUDE.md 后 AGENTS.md,已经加载过的 AGENTS.md 不重复读 |
claude-md |
只读你的 CLAUDE.md 文件 |
managed-only |
只读组织托管的 CLAUDE.md 和启动时的自动记忆;项目、本地、用户的 CLAUDE.md 与启动时的普通 .claude/rules/ 文件被排除,带 paths 声明的路径范围规则仍按需加载,所有 AGENTS.md 也被排除 |
AGENTS.md 什么时候会被读
仓库里同时有 AGENTS.md 和 CLAUDE.md 时,Claude 读的是后者。判定范围是工作目录及其上层目录里的 CLAUDE.md、.claude/CLAUDE.md 或 CLAUDE.local.md,只要存在其中之一,AGENTS.md 就不会被读,除非把 Project instructions 设成 claude-md-and-agents-md。用户级 ~/.claude/CLAUDE.md、组织托管的 CLAUDE.md 和 .claude/rules/ 不计入这个判定,它们仍然和 AGENTS.md 一起加载。AGENTS.local.md、AGENTS.override.md 和 .agents/ 目录下的文件不会被读。
版本要求:AGENTS.md 支持需要 v2.1.277 或更高。在 v2.1.281 之前,Amazon Bedrock 上的会话和禁用遥测的会话也读不到它,这些版本要升到 v2.1.281 或更高。从 v2.1.276 或更早版本升级上来的话,第一个会话可能读不到,从下一个会话开始读。
managed-only 下个人配置为什么不生效
团队统一切到这个取值之后,个人配置看起来像是丢了,其实是被这一层挡住了:项目、本地、用户的 CLAUDE.md 和启动时的普通 .claude/rules/ 文件不再进会话,带 paths 声明的规则仍会在匹配文件出现时加载。想保留的个人习惯,可以跟团队商量哪一条值得提升到托管文件里,组织约定和个人偏好就不会互相打架。
本地这些记忆文件管的是 Claude 读到什么,团队层面的模型接入和费用是另一条线。MixRoute 的定价页与首页可见文字公开的是 0% 平台费和 250+ 模型,需要把团队的调用收口时,可以带着现有的目录结构和调用规模,确认团队层面的模型接入方案。
FAQ
Claude Code 的记忆文件都在同一个地方吗?
不在,位置跟着作用域走。组织级由 IT 或 DevOps 部署到托管路径,用户级是 ~/.claude/CLAUDE.md,项目级是 ./CLAUDE.md 或 ./.claude/CLAUDE.md,本地是 ./CLAUDE.local.md,Claude 写的自动记忆按仓库收在用户目录下。一条规则没生效,先看它在哪一层:放用户级对所有项目生效,放项目级只影响这个仓库。
自动记忆是每轮对话结束就提取一次吗?
不是。是否保存由 Claude 自己判断,更细的触发时机官方没有公开,所以刚说过的规则不一定已经写进记忆。用 /memory 看条目在不在;不在就直接让 Claude 记住它,或者把这条规则写进 CLAUDE.md,它每个会话都会加载。
自动记忆默认是开着的吗,怎么关掉?
本地会话里默认开着。关闭方式是在 settings.json 里设 autoMemoryEnabled: false,也可以在 /memory 里切换开关;在后台会话和由其他 Claude Code 会话启动的会话里,这个开关只能关、不能再打开。团队要统一设置的话,把这条写进项目级配置,比逐个人交代更省事,也省得有人关掉之后再来问为什么记忆没生效。
保存下来的记忆会自己过期吗?
不会。官方文档写明,记忆目录里的文件不在会话记录的定期清理范围内,MEMORY.md 和主题文件会一直留着,直到你或 Claude 编辑或删除它们。所以要隔一段时间清一遍;删主题文件时,索引里对应的那一行一起删。
我写的 CLAUDE.md 好像没生效,先查什么?
先看 /context 里的 Memory files 列表。启动时该加载的文件不在列表里,Claude 就读不到;文件超过 4 MiB 也会被整份跳过。列表里有却仍然不遵守,就把指令写具体,比如“使用 2 空格缩进”而不是“把代码格式化好”,再看几个文件之间有没有互相矛盾的指令,两条冲突的规则,Claude 可能任选一条。
为什么 AGENTS.md 没有被读?
最常见的原因是工作目录或其上层已经有 CLAUDE.md、.claude/CLAUDE.md 或 CLAUDE.local.md,这时 Claude 读 CLAUDE.md 而不是 AGENTS.md,除非把 Project instructions 设成 claude-md-and-agents-md。版本也要在 v2.1.277 或更高;刚从 v2.1.276 或更早版本升上来,第一个会话读不到的话,下一个会话再试。
记忆文件写太多会有什么影响?
会挤掉真正相关的内容。自动记忆每个会话只把索引的前 200 行或 25KB 加载进上下文,超出的部分不进来,条目还要求每条一行。把整篇规范搬进记忆,会挤掉真正相关的条目,需要跨文件生效的规范更适合放进代码库的文档目录或路径范围规则。索引超限时终端里不会弹出提示,错误只返回给 Claude,后面那些记忆事实上读不到,这也是定期清理的另一个理由。